一張 GB10,能讓多少人同時用語音輸入?
懶注注/说你也行 的語音辨識(Breeze-ASR-25)容量研究。DGX 上整夜實測+業界做法調查,2026-10-16。
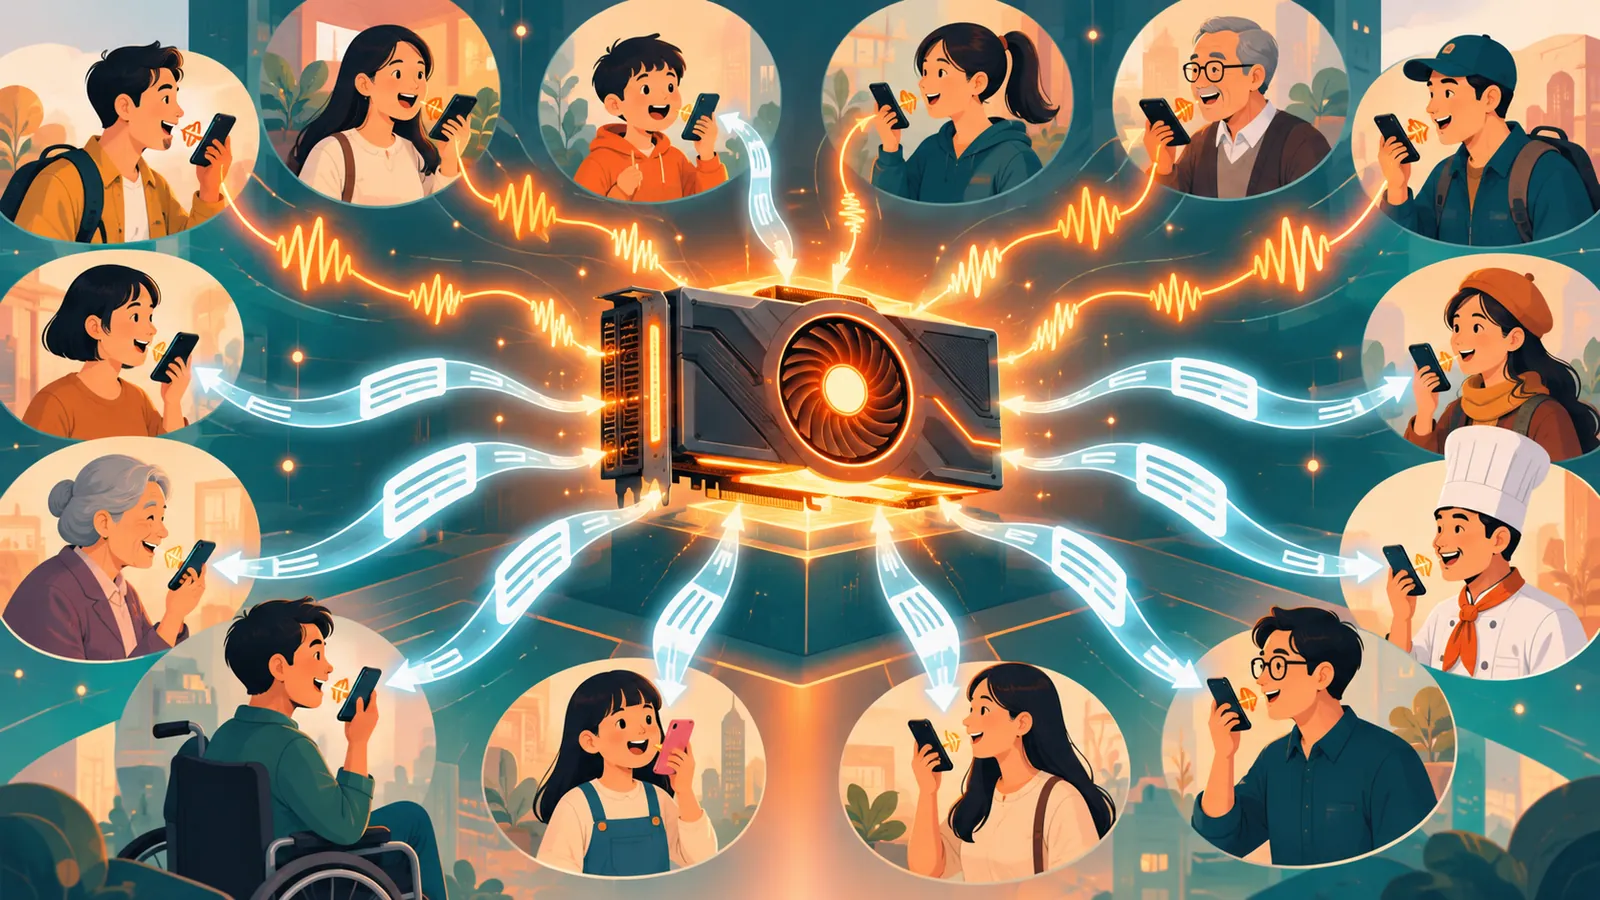
≈ 同時在線 2 人
≈ 同時在線 12–29 人
≈ 同時在線 48 人(定稿面)
「穩」的定義:逐字預覽和最後定稿,90 % 的時候都在 1 秒內出來。「4–8 人」:嚴格標準 4 人;預覽放寬到 1.15 秒是 8 人。 「同時在線」假設每個人只有 1/6 的時間在說話,95 % 的時間不超載。模擬的是每個人不停地講,比真實使用重,所以這些都是保守值。
1. 卡住的是 GPU 時間,不是模型只有一份
直覺的做法是「多開幾個辨識程式」。實測:開 1 個、2 個、3 個,每秒總共能處理的句子數都一樣(3.7–4.0 句)。 GPU 是輪流分給每個程式的,多開只是把同一塊餅切得更細,每個人反而都變慢。
每秒能轉幾句話(一句約 4.4 秒,越長越好)
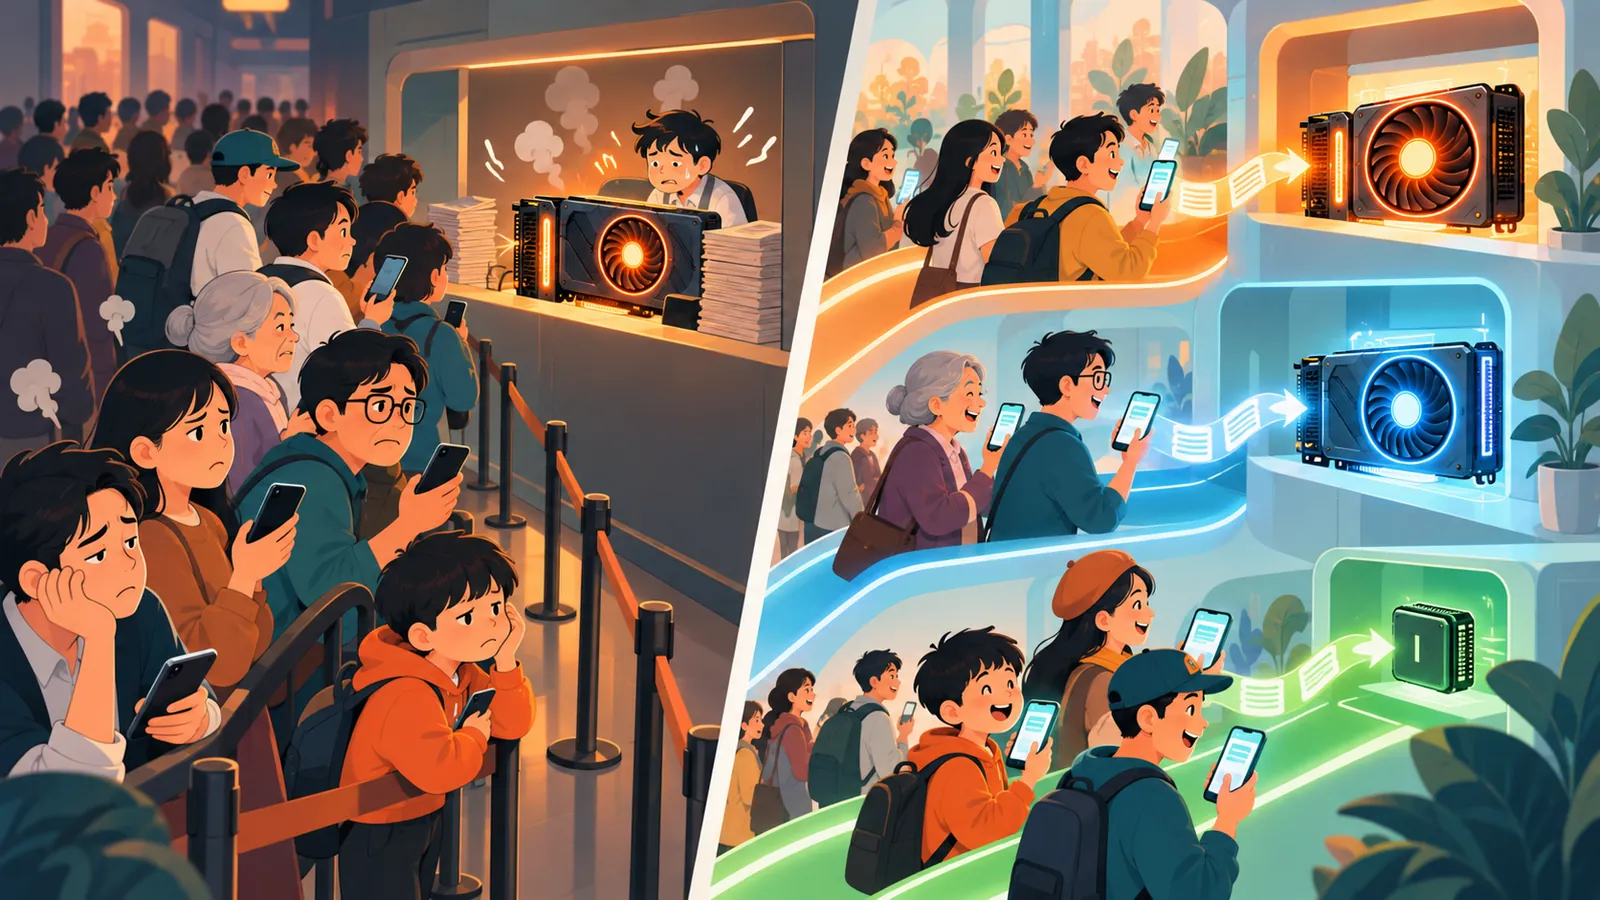
2. 「一個模型配多個 KV cache」可以嗎?可以,但只快 2 倍
這就是 vLLM 的「連續批次」:權重只載一份,每個人各有自己的 KV cache,同一步一起算。在我們的 GB10 上跑得起來, 轉出來的字跟現在完全一樣(72 句錯字率都是 1.68 %),每秒處理量約 2 倍(8.0–8.4 句 vs 4.0 句)。
為什麼不是 10 倍?
Whisper 系模型不管你講 2 秒還是 12 秒,都要先把音訊補到 30 秒,跑一次「聽」的部分(encoder)。這一步在 GB10 上固定 61 毫秒, 而且一起算不會打折:一次算 16 個人就是 16 倍時間。批次只能省「寫字」的部分(decoder),所以天花板大約是每秒 16 句,vLLM 已經做到 8.4。
| 一次算幾個人 | 1 | 2 | 4 | 8 | 16 |
|---|---|---|---|---|---|
| 「聽」(encoder) | 61 ms | 120 ms | 240 ms | 504 ms | 1029 ms |
| 「寫一個字」(decoder,每人平均) | 13.9 ms | — | 4.0 ms | 2.6 ms | 1.9 ms |
業界同一個結論:vLLM 維護者在 2025-09 也寫「一堆短轉錄請求時,瓶頸是 encoder」[S3];之後加了 encoder 批次,自報 +37 % [S4]。
3. 真正拖慢大家的是「定稿」
打字時你看到的字有兩種:講話中一直更新的預覽,和講完那一刻的定稿。原本的設計讓預覽一直佔著 GPU,定稿被擠到後面: 4 個人同時講,定稿要等 2.7 秒;8 個人要 8.5 秒。
「定稿優先」:只要有人的定稿在算,新的 GPU 預覽就先等一下(最多 1.5 秒;CPU 那條預覽不受影響)。只改了 stream server 幾行,沒有加任何服務。
定稿等多久(90 % 的人在這時間內拿到,越短越好;綠虛線=1 秒)
代價:8 個人同時講時,預覽從 0.70 秒變 1.13 秒。只有 1 個人講話時也有好處:定稿從 0.83 秒變 0.47 秒(下一段的預覽不再跟上一段的定稿搶)。 上線前用真的程式碼重跑了一次驗收:1/4/8 人定稿 0.82/1.47/8.50 秒 → 0.48/0.70/0.79 秒。
4. 做了什麼、接下來做什麼
| 項目 | 效果 | 狀態 |
|---|---|---|
| 定稿優先 | 同時講話 1 → 4 人(放寬 8 人) | 已上線10/16 |
| Breeze 換 q5_0 | 再快約 9 %,72 句輸出跟原本一字不差 | 已上線10/16 |
| 定稿改由 vLLM 批次處理(:8116,原本的留著當備援) | 定稿撐到 12 人同時講(原本 12 人要 3.2 秒) | 下一步常駐約 8.8 GB |
| 會議長錄音改用 faster-whisper 批次 | 6 分鐘錄音 12.1 → 5.5 秒,錯字更少;不再讓所有人的定稿排隊 | 下一步 |
| V100 當第二張卡 | 容量約再多一張卡 | 要你決定驅動版本不符,要重開機(會中斷上面跑的 27B 服務) |
| 多開 whisper.cpp 實例 | 沒有變多,只是每個人變慢 | 不做 |
| 把「聽」的視窗縮短(audio_ctx) | Breeze 錯字率從 1.7 % 崩到 50 %–148 % | 不做 |
| 預覽也全部交給 vLLM | 預覽只到 4 人,還拖慢定稿 | 不做 |
| CTranslate2 當即時引擎 | GB10 上「聽」慢 2.5 倍 | 不做 |
按需啟動:第二個預覽解碼器(:8115)已經是按需的——沒人用 5 分鐘就關掉,有人用 3 秒內醒來,期間預覽先走 CPU。 vLLM 定稿服務啟動要 20–90 秒,不適合按需,所以規劃成常駐(8.8 GB),原本的 :8104 留著當退路。
5. 同一張卡上還有別的工作
GPU 有重工作滿載時(修圖、產圖、大模型),語音辨識慢約 3 倍(0.30 → 0.84 秒)。試過的辦法:
- 調 CPU 優先權(nice)、CUDA stream 優先序、GPU 時間片設定:都沒用。
- GB10 沒有 MIG(不能把卡切成幾張小卡)。
- MPS 有用,但有條件:重工作限用 50 % 的運算單元時,ASR 只慢 1.8 倍;不設限的 MPS 反而慢 30 倍。要所有 GPU 服務一起改,是大改動,先不動。
- 最穩的做法:有人在講話時,讓修圖這類批次工作暫停或降速(應用層的閘門),或排在離峰。
6. 再往上:把預覽搬到手機上
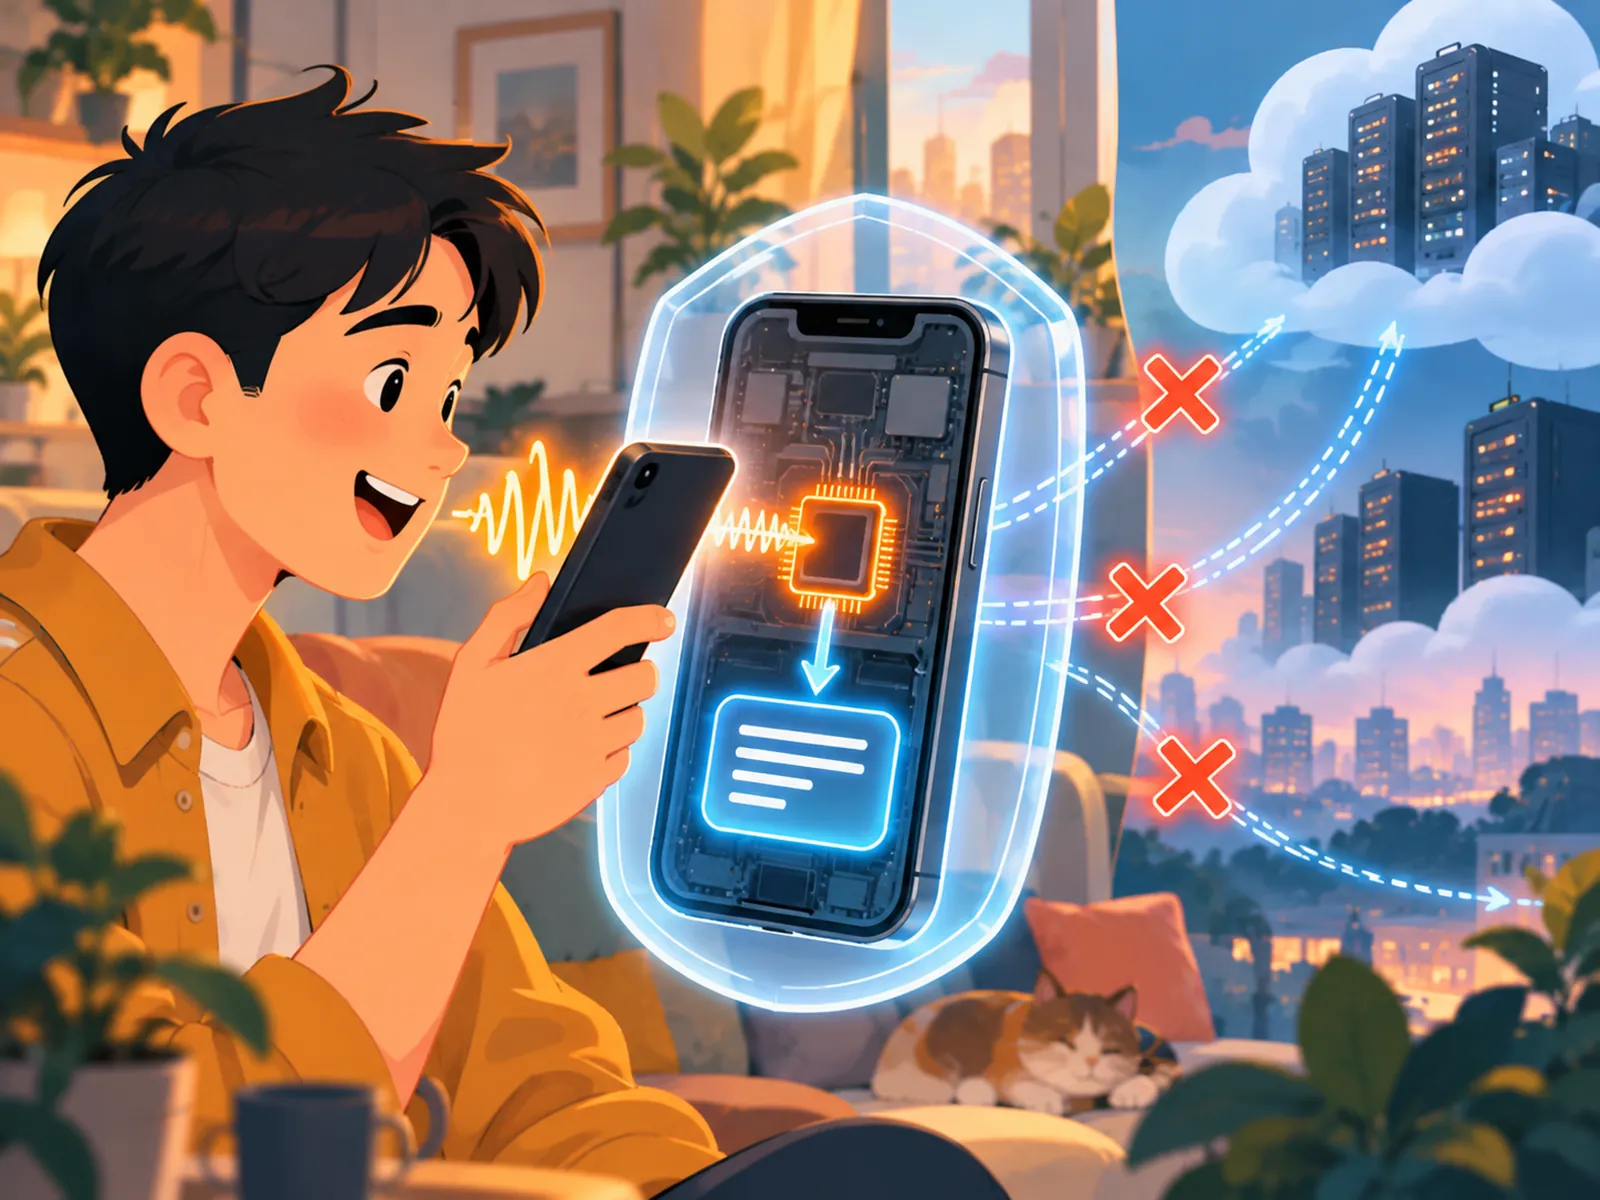
每次預覽重新算都要付那 61 毫秒的「聽」,這是單卡的硬上限。要服務更多人,業界的做法是把預覽交給手機或小模型, 伺服器只做一次準確的定稿——Google 的語音輸入就是這種兩段式設計 [S44]。這樣 GPU 的工作量從「講話人數 × 預覽次數」降成「講話人數」。 说你也行 正在試的手機端辨識也是這條路。
7. 業界怎麼做
| 做法 | 公開數字 | 跟我們的關係 |
|---|---|---|
| vLLM 連續批次+encoder 批次 | encoder 批次 +37 %、decode CUDA graph +33 %(PR 作者自報)[S4] | 我們實測 2 倍,已排進下一步 |
| 先降級預覽、不動定稿 | NVIDIA Riva:串流區塊 160 → 960 ms,A100 可服務的串流數 104 → 490(4.7 倍)[S35] | 「定稿優先」是同一個想法 |
| 入場控制、優先佇列 | Google SRE、AWS:過載時先保住已經開始的工作 [S50];Deepgram 每帳號串流上限 150–300 路 [S41] | 定稿=已開始的工作,優先 |
| 原生串流模型 | Kyutai:一張 H100 400 路即時串流 [S37];Qwen3-ASR 0.6B 有中文基準 [S39] | 要換模型,沒有台灣華語對照,Breeze 的在地優勢可能沒了 |
| 同卡共用 | MPS 優先權只是「提示」[S45];MIG 支援清單沒有 GB10 [S46] | 我們實測吻合:只有限 SM 比例的 MPS 有效 |
| Whisper 硬當串流用 | whisper_streaming 維護者:「GPU 單一程序最快、序列比並行快,不是多用戶產品」[S31] | 解釋了為什麼多開實例沒用 |
8. 怎麼量的、哪些沒量到
- DGX Spark(GB10)上整夜實測,全部在實驗埠跑,正式服務整夜沒動、沒壓測;每個階段開始前確認沒有人在用語音。
- 72 句自然人聲(2–12 秒、三種台灣華語聲音),沒有用任何真人錄音。為了防當機,GPU 鎖在 2 GHz,正式環境約再快 6 %。
- 「同時講話」的數字是用正式程式碼裡的分流函式模擬的,沒有走完整的手機 → WebSocket 流程。
- 沒量到:熱詞提示與投機定稿帶來的額外負擔、CPU 預覽的品質、vLLM 跑好幾天的穩定性。
- 順帶更正:之前引用的「錯字率 7.18 %」是參考答案檔被截斷算錯的,真實是 1.14 %(同一批句子)。
完整數據:各架構的預覽/定稿延遲(p90,秒)
| 同時講話 | 改動前 | 定稿優先 | +vLLM 定稿 | 全部交給 vLLM |
|---|---|---|---|---|
| 1 人 | 0.30 / 0.83 | 0.31 / 0.47 | 0.32 / 0.56 | 0.32 / 0.86 |
| 2 人 | 0.73 / 1.31 | 0.72 / 0.63 | 0.74 / 0.69 | 0.56 / 1.07 |
| 4 人 | 0.67 / 2.69 | 0.65 / 0.58 | 0.74 / 0.71 | 0.99 / 1.64 |
| 8 人 | 0.70 / 8.50 | 1.13 / 0.70 | 1.09 / 0.82 | 1.87 / 3.01 |
| 12 人 | 1.08 / 10.42 | 2.18 / 3.17 | 1.56 / 0.92 | 2.82 / 3.93 |
| 16 人 | 1.59 / 12.75 | 2.16 / 11.28 | 2.07 / 3.67 | 3.62 / 4.89 |
格式:預覽 / 定稿。預覽=同一個人兩次預覽更新的間隔。
來源
- [S3] vLLM issue #24946 — github.com/vllm-project/vllm/issues/24946
- [S4] vLLM PR #29421 / #30072 — github.com/vllm-project/vllm/pull/29421
- [S31] whisper_streaming #138 — github.com/ufal/whisper_streaming/issues/138
- [S35] NVIDIA Riva ASR 效能 — docs.nvidia.com/deeplearning/riva/…/asr-performance.html
- [S37] Kyutai STT — kyutai.org/stt
- [S39] Qwen3-ASR — arxiv.org/abs/2601.21337
- [S41] Deepgram 速率限制 — developers.deepgram.com/reference/api-rate-limits
- [S44] Google 裝置端語音辨識 — research.google/blog/an-all-neural-on-device-speech-recognizer
- [S45] NVIDIA MPS — docs.nvidia.com/deploy/mps
- [S46] MIG 支援清單 — docs.nvidia.com/datacenter/tesla/mig-user-guide/supported-gpus.html
- [S50] Google SRE:處理過載 — sre.google/sre-book/handling-overload